

Вступление: почему в 2026 код-ревью — это “ускоритель”, а не “церемония”
Код-ревью часто воспринимают как обязательный ритуал: “кто-то должен посмотреть PR перед мерджем”. На практике ревью — это один из самых дешёвых способов снизить дефекты в проде, удержать архитектуру в рамках и не платить проценты по техническому долгу. А ещё — ускорять разработку, если процесс настроен правильно.
В 2026-м нагрузка на команды растёт: релизы чаще, стек сложнее, зависимостей больше, а время на “переосмыслить” — меньше. Поэтому код-ревью процесс перестаёт быть просто проверкой синтаксиса. Это контроль качества, дисциплина архитектуры и элемент управления рисками. В проектах, где ревью кода в команде поставлено грамотно, быстрее выравнивается стиль, меньше “скрытых” регрессий, проще онбординг, ниже стоимость изменений.
При этом код-ревью легко превратить в тормоз: бесконечные придирки, переписки на 60 комментариев, “переделай всё”, блокировки без договорённостей, ревью ради ревью. Ниже — правила code review и конкретные практики, которыми пользуется команда RUSO и которые масштабируются на разные типы проектов.
1) Что именно мы пытаемся решить код-ревью: цели и границы
Перед тем как писать чеклист код ревью, важно договориться о назначении ревью. Обычно цели такие:
- Снижение дефектов и регрессий (логика, крайние случаи, ошибки интеграций).
- Контроль читаемости и сопровождаемости (понятный код дешевле поддерживать).
- Поддержка архитектурных принципов (границы модулей, зависимости, контракты).
- Безопасность и устойчивость (валидация, права доступа, секреты, ошибки).
- Единые стандарты (стиль, именование, структура проекта).
- Обучение и обмен практиками (особенно важен для роста мидлов/джунов).
Границы ревью тоже надо обозначить, иначе процесс деградирует:
- Ревью — не место “перепридумывать продукт” (если требования не менялись).
- Ревью — не “переписать под свой вкус”, если код соответствует стандартам команды.
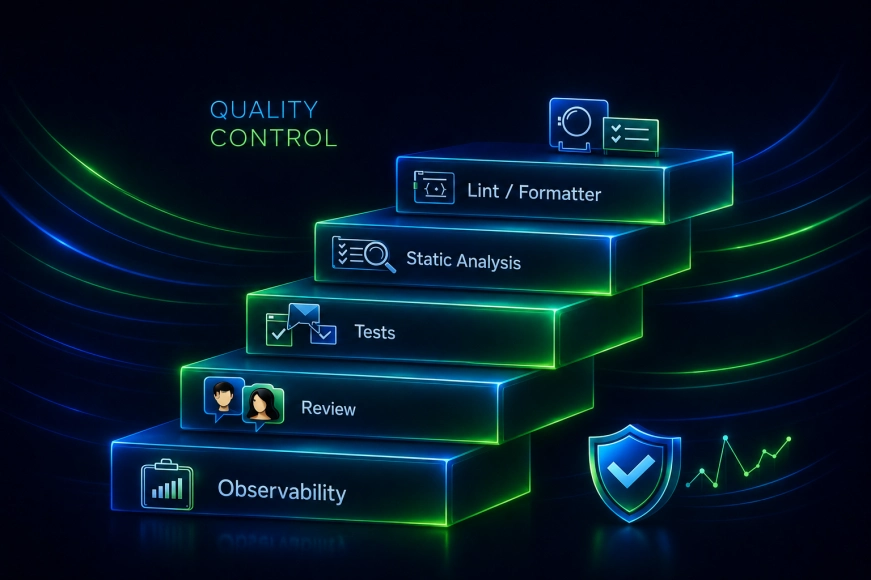
- Ревью — не замена тестам, линтерам и статанализу: это разные уровни контроля.
Ключевой принцип: ревью должно ловить то, что не ловят автоматические проверки, и принимать решения там, где важен контекст (архитектура, риски, читаемость, безопасность).
2) Хороший PR — половина успешного ревью: как готовить изменения
В большинстве команд основной “болезненный” фактор — не ревьюер, а качество исходного PR. Если PR слишком большой, без контекста, без тестов, без структуры — ревью превращается в расследование.
2.1. Размер PR: “маленькие пачки” побеждают
Практика команды RUSO: держать PR настолько маленькими, насколько это возможно, не ломая смысл. Чем меньше PR:
- тем меньше когнитивная нагрузка,
- тем быстрее ревью,
- тем ниже вероятность пропустить дефект.
Ориентир: не “N строк”, а “одна мысль”. Один PR — одна задача/гипотеза/изменение контракта.
2.2. Описание PR: что должно быть всегда
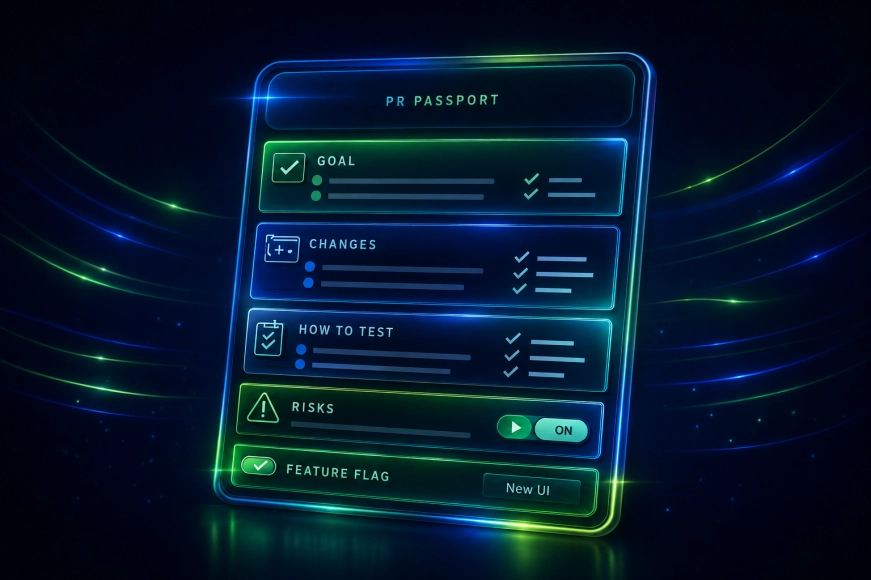
Минимум:
- что изменили (1–3 пункта),
- почему (контекст/ссылка на задачу),
- как проверить (шаги),
- риски (что может сломаться),
- скриншоты/видео для UI,
- миграции/флаги для backend.
Это простой шаг, но он экономит часы.
2.3. “Гейтинг” автоматикой до ревью
То, что можно проверить машиной — проверяем машиной:
- форматтер,
- линтер,
- типизация,
- unit/integration тесты,
- проверка миграций,
- security-скан,
- сборка.
Ревьюер должен тратить внимание на смысл и архитектуру, а не на пробелы и импорты.
3) Роли и ответственность: кто, что и когда проверяет
Код-ревью начинает работать стабильно, когда роли понятны.
- Автор PR отвечает за контекст, тесты, понятное описание и готовность к ревью.
- Ревьюер отвечает за качество итогового решения и риски (не за “идеальность”).
- Техлид/архитектор (при необходимости) — за архитектурные границы и стратегические решения.
- QA/автотесты — за покрытие сценариев там, где это часть процесса.
Практика “двух уровней”:
- Быстрое ревью (10–20 минут): очевидные проблемы, риски, направление.
- Глубокое ревью (по необходимости): критические модули, безопасность, производительность.
И ещё одно: ревью — это сервис внутри команды. Нормально иметь SLA:
- “ответить на ревью в течение X часов в рабочее время”,
- “не держать PR без движения”.
Это резко снижает “простой” задач.
4) Стандарты ревью: как писать комментарии, чтобы ускорять, а не ломать мотивацию
Лучшие практики код-ревью в команде — это не только про код, но и про коммуникацию.
4.1. Маркируйте тип комментария
Сильно ускоряет разбор:
- Blocker — нельзя мерджить (ошибка, безопасность, регрессия, контракт).
- Suggestion — улучшение (читабельность, стиль, микрооптимизация).
- Question — уточнение (почему так, есть ли сценарий).
- Nit — мелочь (если команда допускает, но не злоупотреблять).
4.2. Критикуйте решение, не человека
Формулировки:
- “В этом месте риск N из-за X” вместо “Ты неправильно сделал”.
- “Предлагаю вариант A, потому что…” вместо “Переделай”.
4.3. Давайте “путь к решению”
Замечание без предложений часто порождает переписку. Лучше:
- указать альтернативу,
- привести пример,
- сослаться на стандарт/гайд проекта.
5) Чек-лист код-ревью: на что смотреть в первую очередь
Чтобы как проводить код ревью было одинаково в разных командах, нужен чек-лист. Но он должен быть коротким и “живым”.
5.1. Логика и корректность
- учтены ли крайние случаи,
- правильные ли условия,
- нет ли скрытых “магических” значений,
- корректно ли обрабатываются ошибки.
5.2. Архитектура и границы
- не нарушены ли зависимости модулей,
- не “протекают” ли детали реализации наружу,
- не смешаны ли слои (UI/домен/инфра),
- не создаём ли новый технический долг ради скорости.
5.3. Тестируемость
- есть ли тесты там, где риск высокий,
- можно ли протестировать локально,
- не усложнили ли код так, что его невозможно покрыть.
5.4. Производительность и ресурсы
- N+1 запросы,
- лишние перерендеры,
- тяжёлые операции на горячем пути,
- кеширование.
5.5. Безопасность
- валидация входных данных,
- права доступа,
- утечки секретов,
- корректная работа с PII.
6) Два ключевых решения, которые определяют эффективность ревью
Ниже — два “узких места”, где команды чаще всего теряют скорость. Для этих блоков добавим таблицы.
6.1. Что считать “блокером”, а что — “рекомендацией” (таблица)
Если нет договорённости, всё становится блокером — и ревью тормозит релизы.
Таблица 1. Классификация замечаний в код-ревью
|
Тип замечания |
Когда применяем |
Пример |
Статус |
|
Blocker (обязательное) |
риск регрессии/безопасности/контракта |
сломали API-контракт, нет обработки ошибки, уязвимость |
Мердж запрещён |
|
High |
сильный риск поддержки/архитектуры |
зависимость слоя UI от DB, рост техдолга в критичном месте |
Обычно блокер по договорённости |
|
Medium |
улучшение читаемости/структуры |
длинная функция, непонятные имена |
Не блокирует, если сроки горят |
|
Low / Nit |
косметика |
форматирование, порядок импортов (если нет автоформаттера) |
Не блокирует |
Позиция нашей команды: блокерами должны быть только вещи, которые реально увеличивают риск или стоимость изменений. Остальное — предложения, которые можно вынести в техдолг/бэклог.
6.2. Модель ревью: “один ревьюер” или “пара ревьюеров”, и где подключать AI (таблица)
Сейчас команды всё чаще используют AI-инструменты как помощника: подсветить потенциальные проблемы, предложить тест-кейсы, проверить стиль, найти “опасные” места. Но это не замена опытного ревьюера — особенно в архитектуре и контексте продукта.
Таблица 2. Сравнение моделей ревью
|
Модель |
Плюсы |
Минусы |
Где подходит |
|
1 ревьюер |
быстро, дешево |
риск “слепых зон” |
типовые изменения, зрелый кодстайл |
|
2 ревьюера (разные роли) |
лучше ловит архитектуру/перф/безопасность |
дольше по времени |
критические модули, публичные API |
|
Ревью + AI-ассистент |
ускоряет поиск типовых проблем, помогает с тестами и стилем |
может ошибаться без контекста |
большие команды, частые релизы |
|
“Ротация ревьюеров” |
равномерная нагрузка, рост команды |
нужен контроль качества |
продуктовые команды 6+ человек |
Практика команды RUSO: AI-ассистент подключаем как “первый фильтр”, а окончательное решение — за человеком. Особенно важно: архитектурные изменения и управляемость технического долга AI не оценит без знания вашей системы.
7) Метрики ревью: что реально измерять, чтобы улучшать процесс
Измерения нужны не для контроля людей, а для оптимизации процесса. Полезные метрики:
- Time to first review: сколько ждёт PR первого ответа.
- Time to merge: сколько живёт PR от открытия до мерджа.
- Размер PR: средний объём изменений (как индикатор разбиения задач).
- Доля “возвратов”: сколько PR уходят на серьёзную переделку.
- Дефекты после мерджа: баги, связанные с изменениями.
Важно: метрики без контекста вредны. Например, “быстро мерджим” может означать “плохо проверяем”. Поэтому метрики должны обсуждаться на ретро, а не превращаться в KPI.
8) Типовые антипаттерны: как ломается код-ревью (и как чинить)
- “PR на 2000 строк” → дробить, выносить рефакторинг отдельно, вводить лимиты.
- “Ревью как соревнование эго” → вводить правила комментариев, маркировку приоритетов.
- “Ревью только по стилю” → автоматизировать стиль, оставить людям смысл.
- “Молча мерджим” → минимальный стандарт: описание, тесты, чек-лист.
- “Вечные блокировки” → SLA на ответы, ротация ревьюеров, окна ревью.
Обычно достаточно 2–3 договорённостей, чтобы процесс стал заметно стабильнее.
9) Выводы: коротко, что внедрять в первую неделю
- Договориться о целях ревью и “что считается блокером”.
- Ввести “паспорт PR” (описание + шаги проверки + риски).
- Автоматизировать стиль/линт/тесты до ревью.
- Держать PR маленькими и смысловыми.
- Подключить AI-ассистент как фильтр, но не как финального арбитра.
- Начать мерить time-to-first-review и time-to-merge.